基于强化学习的半主动悬架舒适性控制
TD3 智能体直接输出阻尼力,多目标奖励兼顾舒适性、悬架行程与轮胎接地性
| 时间:2026.01 – 2026.03 | 结果:相对 SH-ADD,簧上质量加速度降低 52% |
问题引入
半主动悬架的经典控制律——Skyhook(SH)、ADD、SH-ADD——都建立在清晰的物理直觉上,参数少、鲁棒性好。但它们的权衡是写死的:
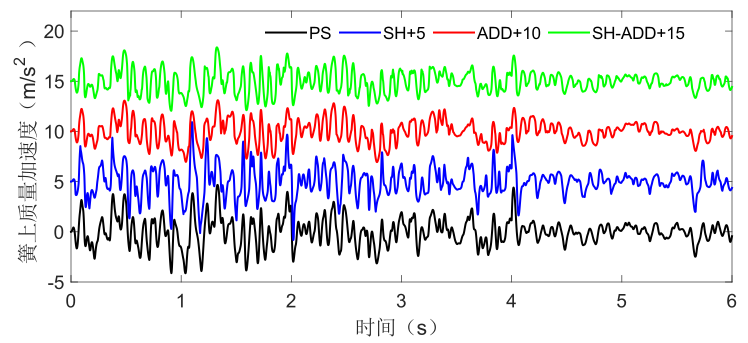
\[c_{SH} = \begin{cases} c_{\max}, & \dot{z}_s \,(\dot{z}_s - \dot{z}_u) \geq 0 \\ c_{\min}, & \text{否则} \end{cases} \qquad c_{ADD} = \begin{cases} c_{\max}, & \ddot{z}_s \,(\dot{z}_s - \dot{z}_u) \geq 0 \\ c_{\min}, & \text{否则} \end{cases}\]Skyhook 用簧上速度判据,偏向低频车身姿态;ADD 用簧上加速度判据,偏向高频舒适性;SH-ADD 在两者间按频率切换。一旦路面激励的统计特性变化,这套固定判据就不再是最优。而且它们都是开关型输出——阻尼在 \(c_{\min}\) 与 \(c_{\max}\) 之间硬跳变。
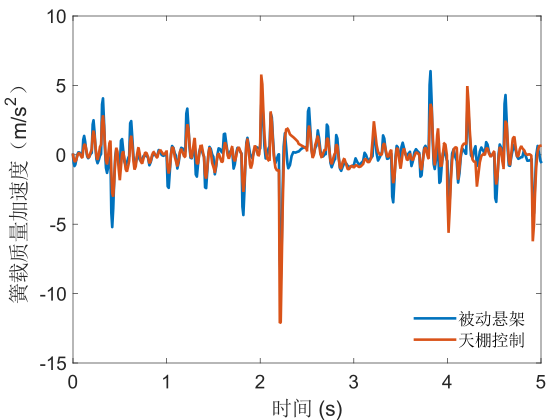
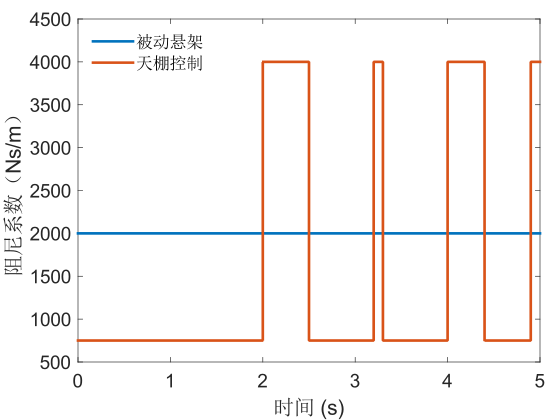
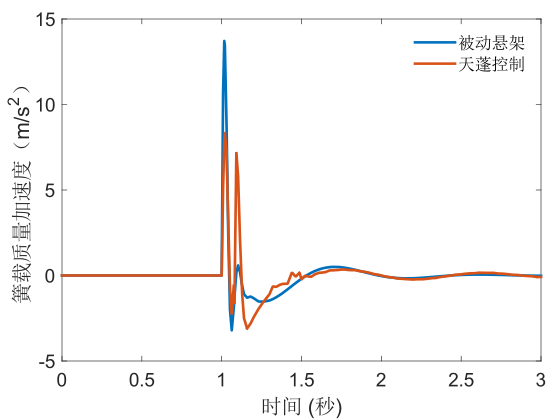
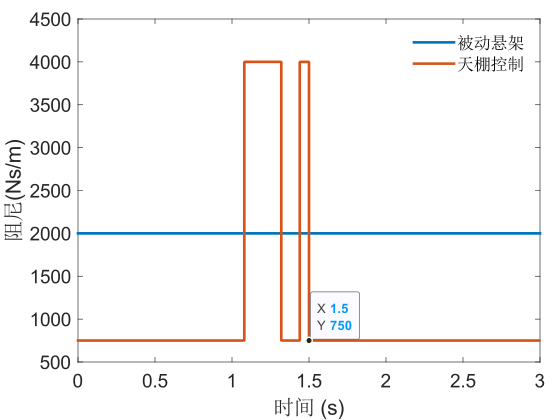
这项工作的出发点是:把”什么时候该偏向哪个目标、该出多大力”交给数据去学,而不是人工整定判据。
路面模型与工况
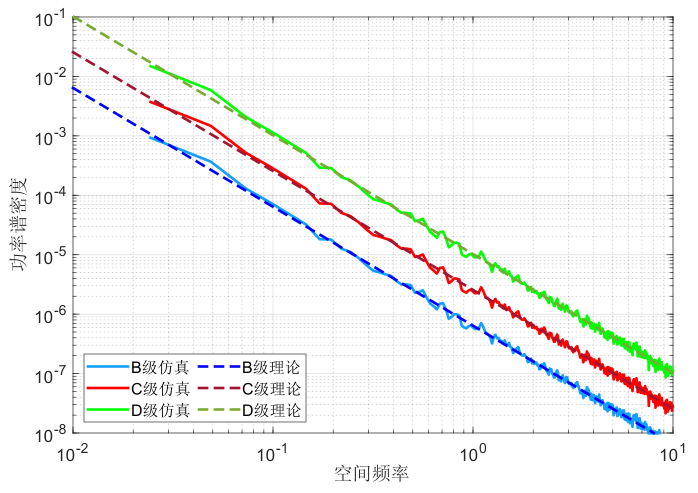
用滤波白噪声法生成 B、C、D 三级随机路面。先验证路面模型本身——把仿真得到的位移功率谱密度与 ISO 8608 理论谱对比:
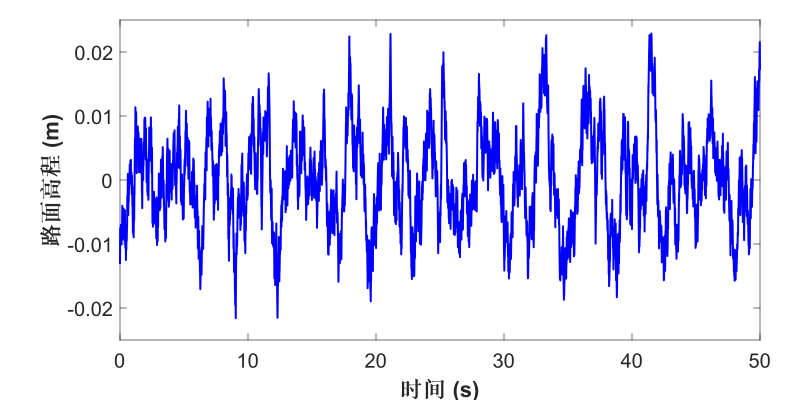
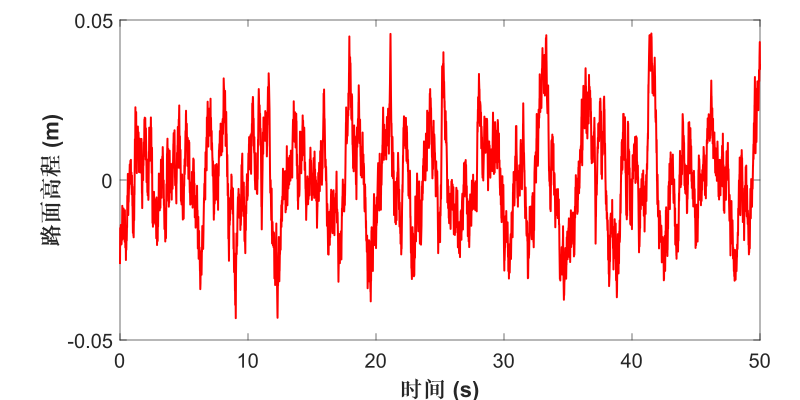
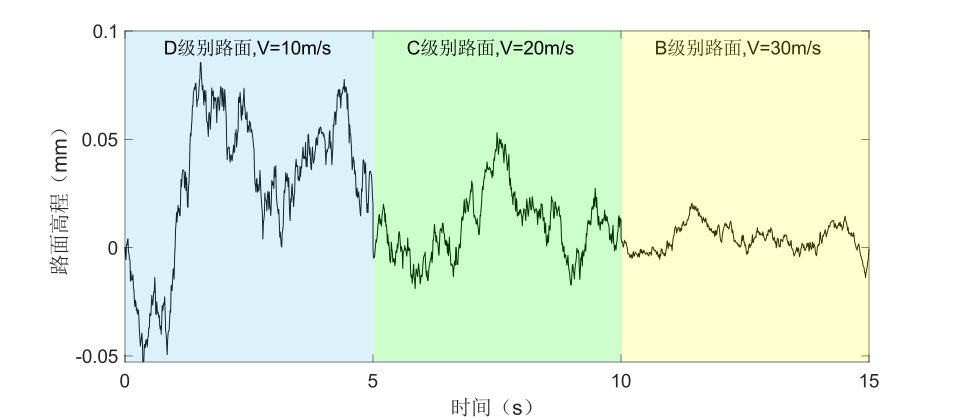
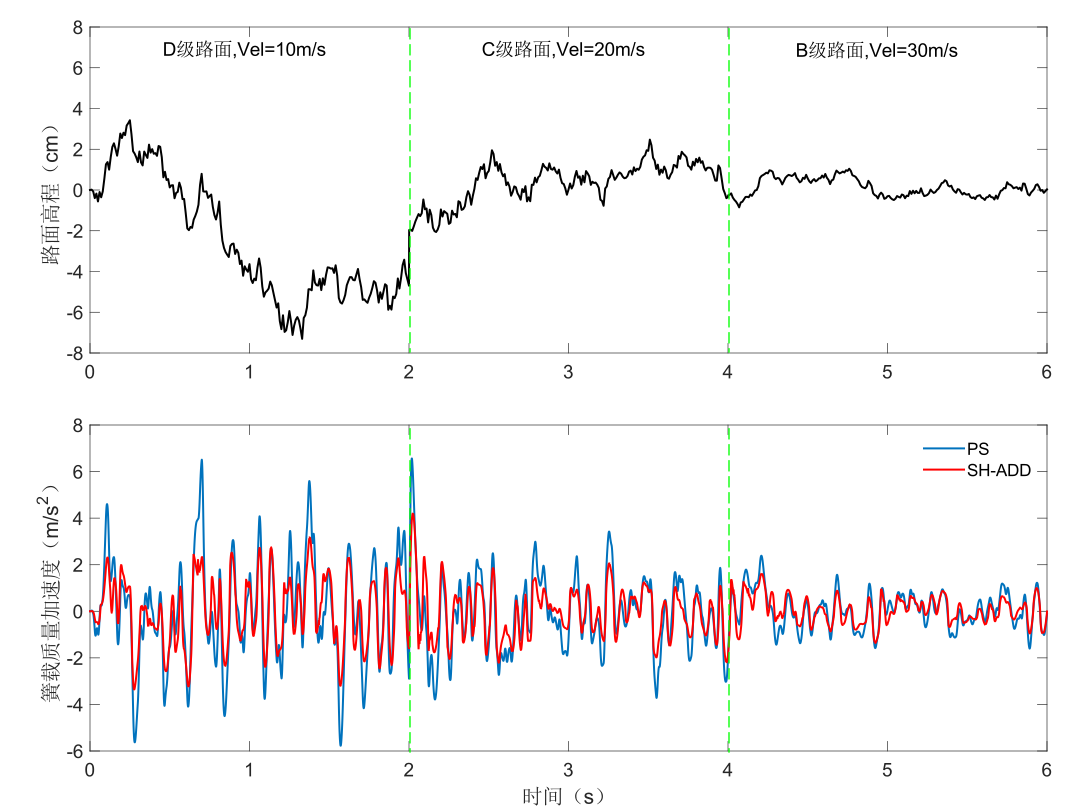
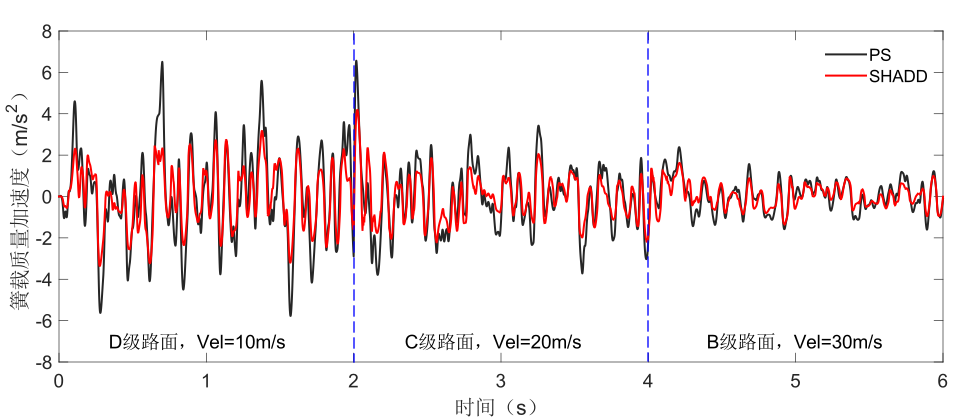
为了检验策略对工况变化的适应性,设计了一个三段变工况场景:D 级路面 10 m/s → C 级路面 20 m/s → B 级路面 30 m/s。路面等级变好的同时车速升高,激励的频率成分随之改变。
TD3 智能体
为什么是 TD3:半主动悬架是连续动作控制,DDPG 类方法会因 Q 值高估导致阻尼指令震荡。TD3 的三项改进——双 Critic 取小、目标策略平滑、Actor 延迟更新——恰好对症。
\[y \leftarrow r + \gamma \min_{i=1,2} Q_{\theta_i'}\big(s', \pi_{\phi'}(s') + \epsilon\big), \qquad \epsilon \sim \mathrm{clip}\big(\mathcal{N}(0,\sigma),\,-c,\,c\big)\]状态(4 维):簧上加速度 \(\ddot{z}_s\)、悬架动挠度 \(z_s - z_u\)、相对速度 \(\dot{z}_s - \dot{z}_u\)、簧上速度 \(\dot{z}_s\)。
动作(1 维连续):阻尼力,直接受 \([F_{\min}, F_{\max}]\) 约束——不是在两档阻尼间开关,而是连续给力。
| 网络 | 结构 |
|---|---|
| Actor | 4 → 512 → 128 → 1,ReLU + tanh,再经 scaling 层映射到力的物理范围 |
| Critic ×2 | 状态支路 4 → 512 → 256;动作支路 1 → 256;拼接后 → 256 → 128 → 1 |
| 超参数 | 取值 |
|---|---|
| 学习率(Actor / Critic) | 1×10⁻⁴ |
| 折扣因子 \(\gamma\) | 0.99 |
| 经验回放容量 | 1×10⁶ |
| 批大小 | 128 |
| 目标网络平滑系数 | 1×10⁻³ |
| 探索噪声标准差 | 0.2,衰减率 1×10⁻⁴,下限 0.01 |
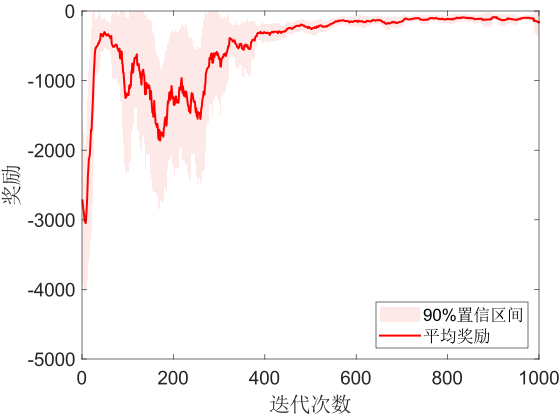
| 训练回合数 | 1000 |
奖励函数:软项 + 硬项 + 越界惩罚
多目标奖励真正的难点不是”权重怎么配”,而是四个目标压根不在一个数量级上:
| 奖励变量 | 单位 | 典型量级 |
|---|---|---|
| 簧上加速度 \(\ddot{z}_s\) | m/s² | 1 – 10 |
| 悬架动挠度 \(z_s - z_u\) | m | 0.01 – 0.05 |
| 轮胎动变形 \(z_u - z_q\) | m | 0.001 – 0.01 |
| 阻尼力 \(F\) | N | 10² – 10³ |
按最直觉的写法把四项平方后直接加权求和,力项的数值会比轮胎变形大五个数量级——权重 \(K\) 表达的就不再是”目标之间怎么取舍”,而是”谁的单位大”。网络在这种奖励上学到的是拟合力的幅值,而不是振动特性。
软项先把每个量除以自己的特征尺度 \(\omega_i\) 再加权:
\[r_s = -\sum_{i=1}^{4} K_i \left( \frac{|x_i|}{\omega_i} \right)^2, \qquad x = \big[\ddot{z}_s,\; z_s - z_u,\; z_u - z_q,\; F\big]\]其中 \(K = [0.7,\, 0.1,\, 0.1,\, 0.1]\),\(\omega = [2,\, 0.15,\, 0.15,\, 3]\)。\(\omega\) 取各物理量正常工作范围的上界,本质上是把工程先验写进奖励——归一化之后四项落在同一量级,\(K\) 才真正是权重。舒适性占 0.7 绝对主导,其余三项各 0.1,体现”以舒适性为目标、其他为约束”的取向。这一步同时让加速度信息不被力项淹没,收敛明显更快。
硬项只盯加速度,用取整做成阶梯式惩罚:
\[r_h = -k_h \left| \left\lfloor \alpha_1 |\ddot{z}_s| \right\rfloor \right|, \qquad k_h = 5,\; \alpha_1 = 0.25\]取整的作用是把连续惩罚变成开关:加速度不到 4 m/s² 时硬项恒为 0,越过一档整体跳到 \(-5\),再越再跳。软项负责”往好里调”,硬项负责”别越界”,两者分工明确。
越界惩罚守三条线,每违反一条扣 10 分:
\[P = -10\big[\,|z_s - z_u| > 0.05\,\big] -10\big[\,|\Delta F| > 2\,\big] -10\big[\,(z_s - z_u)\, F > 0\,\big]\]依次对应:悬架行程逼近限位、阻尼力变化率过快、出力方向落在半主动阻尼器不该工作的象限——半主动悬架只能耗散能量、不能主动做功,这一项把该边界写进奖励。
最终奖励为 \(r = r_s + r_h + P\),裁剪到 \([-5,\, 0]\)。
回合终止是另一套更宽的阈值:动挠度超过 0.1 m 或簧上加速度超过 20 m/s² 时直接结束本回合,不再让智能体在已经发散的状态上继续采样。
执行器侧还有一道硬约束:Actor 输出经 tanh 后映射到 \([F_{\min}, F_{\max}]\),力在网络出口就被钳死在执行器能力范围内。奖励里的硬项罚的是”逼近危险”,Actor 限幅保证的是”绝不越界”——只靠奖励惩罚,训练早期仍会输出物理上给不出的力,两道防线互补。
训练收敛
结果
与传统控制律的对比
先看三条经典控制律本身的差异(曲线纵向偏移以便区分):
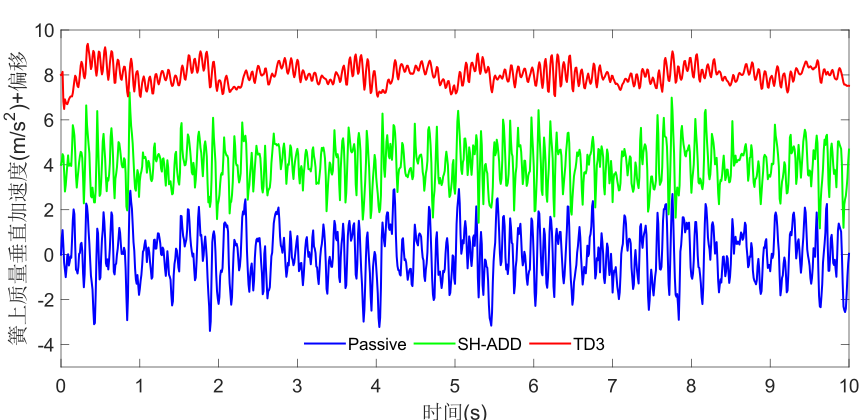
再看加入 TD3 之后:
四种策略同台
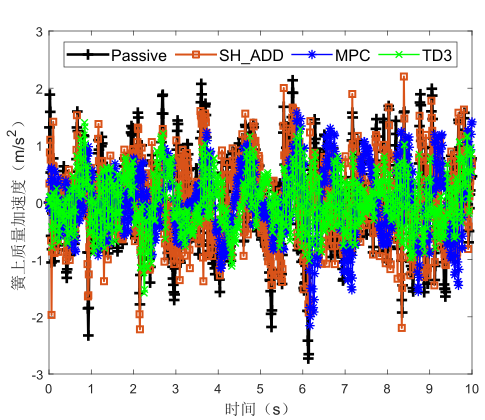
相对 SH-ADD,TD3 将簧上质量加速度降低 52%,同时悬架动挠度与轮胎动载荷都保持在约束范围内——奖励里的越界惩罚与回合终止条件共同保证了这一点。
变工况适应性
我的工作
1/4 车辆动力学模型与随机路面模型的搭建与验证、TD3 智能体的网络设计与训练环境实现、多目标奖励函数(软项归一化 / 硬项阶梯惩罚 / 越界惩罚三层结构)的设计与调参、与 Skyhook / ADD / SH-ADD / MPC 四类基准的对比试验。
工具:MATLAB / Simulink、Reinforcement Learning Toolbox(TD3)、Model Predictive Control Toolbox